Das Problem
Die häufigste Frage bei KI-Projekten ist nicht, ob KI funktioniert, sondern wohin die Daten dabei fließen. Für Belege, Verträge und Patientendokumente ist die ehrlichste Antwort oft: Sie dürfen das Haus nicht verlassen. Also tippt jemand Rechnungsnummer, Datum und Betrag ab, Beleg für Beleg.
Der Ansatz
Doks ist eine Desktop-Anwendung, die Belege vollständig lokal liest. Zu jeder Angabe zeigt sie die Stelle im Beleg, an der sie steht. Was sicher erkannt ist, geht direkt weiter; nur was nicht eindeutig ist, landet zur Prüfung bei einem Menschen.
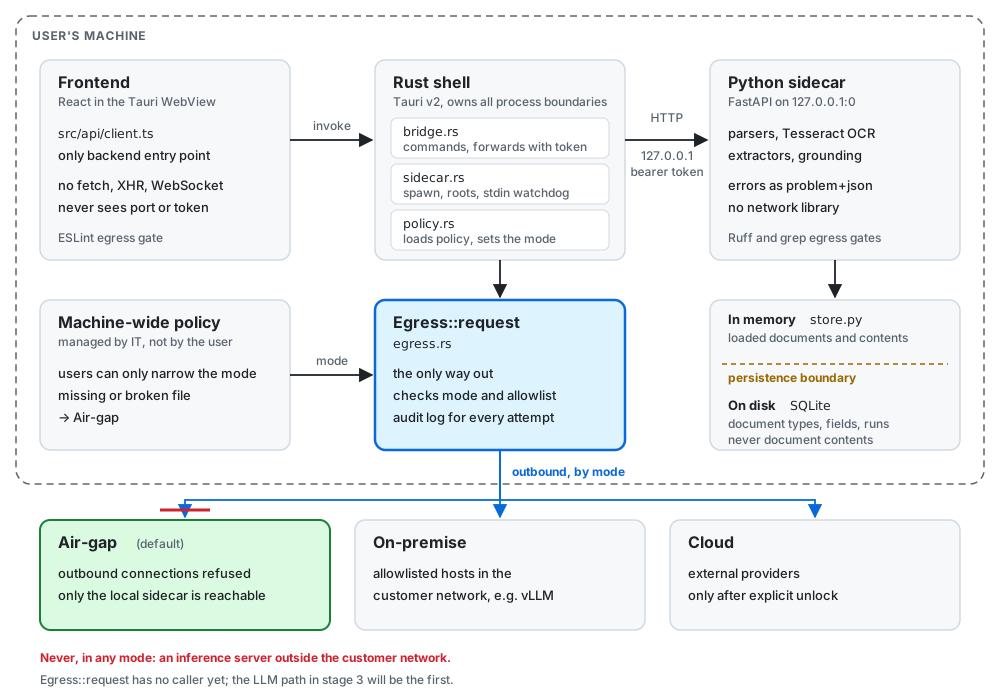
Entscheidend ist, wie die Lokalität durchgesetzt wird: nicht per Konfigurationsschalter, der sich unbemerkt umgehen ließe, sondern technisch. Jeder ausgehende Netzwerkzugriff läuft durch genau eine Stelle im Code. Das Frontend hat keinen HTTP-Client, der Verarbeitungsdienst keine Netzwerkbibliothek, und drei Prüfungen in der CI setzen das bei jedem Commit durch. Diese Prüfung ist negativ getestet: Ein testweise eingebauter Netzwerkaufruf lässt den Build nachweislich scheitern.
- Drei Prozesse, eine Richtung: React-Frontend, Rust-Shell als Nadelöhr, Python-Sidecar auf localhost mit Sitzungstoken.
- Gemessen statt versprochen: 12 bis 16 ms je PDF-Seite mit Text-Layer, gegen ein Budget von 100 ms.
- Zielhardware ist ein normales Notebook mit 16 GB RAM, keine GPU, kein Serverschrank.
- Ein Wert vom lokalen Sprachmodell zählt nur, wenn er wörtlich im Beleg steht; sonst wird er verworfen.
- Ehrliches Fehlverhalten: Ein Bild ohne OCR meldet sich als „kein Text“, statt eine leere Extraktion als Erfolg auszugeben.
So sieht es aus
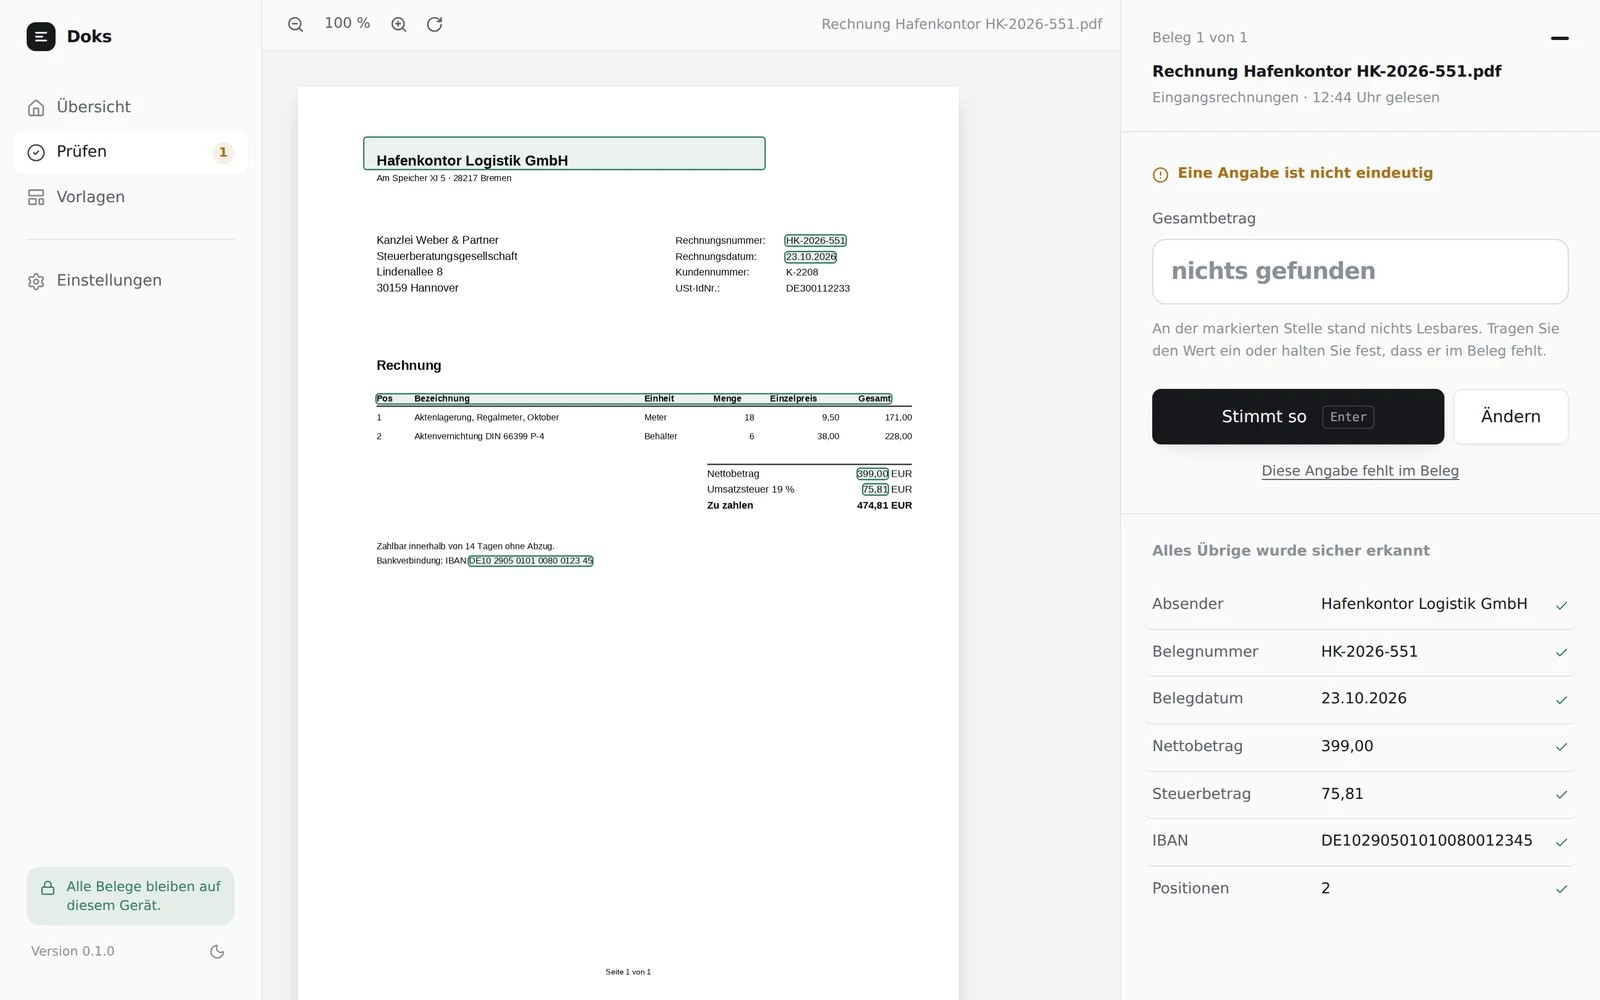
Sechs erfundene Eingangsrechnungen an eine Steuerkanzlei, mit einer Vorlage gelesen. Fünf sind sicher erkannt, eine schreibt ihren Endbetrag anders als üblich und wartet deshalb auf Prüfung. Die Beispiele liegen mit ihrem Generator im Repository.
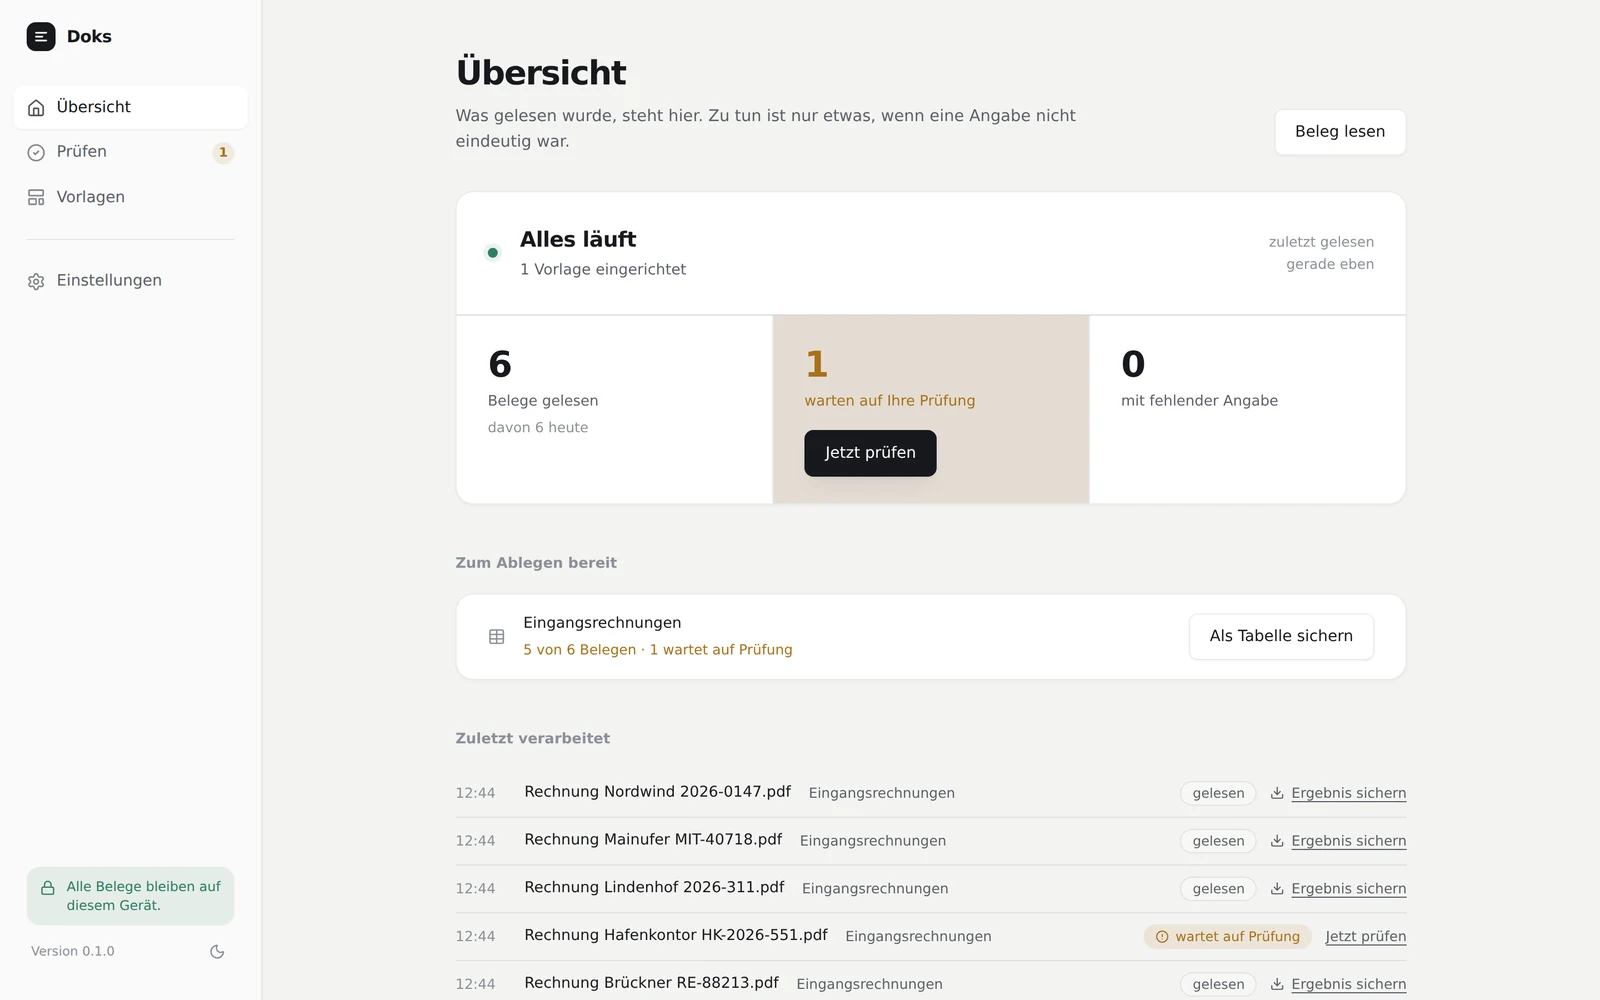
- Die Übersicht: Was sicher erkannt ist, liegt zum Ablegen bereit. Zu tun gibt es nur etwas, wenn eine Angabe nicht eindeutig war. (Helles Theme)
- Prüfen: Die Rechnung schreibt „Zu zahlen“ statt „Gesamtbetrag“. Doks rät nicht, sondern fragt nach; alle übrigen Angaben sind im Beleg markiert. (Helles Theme)
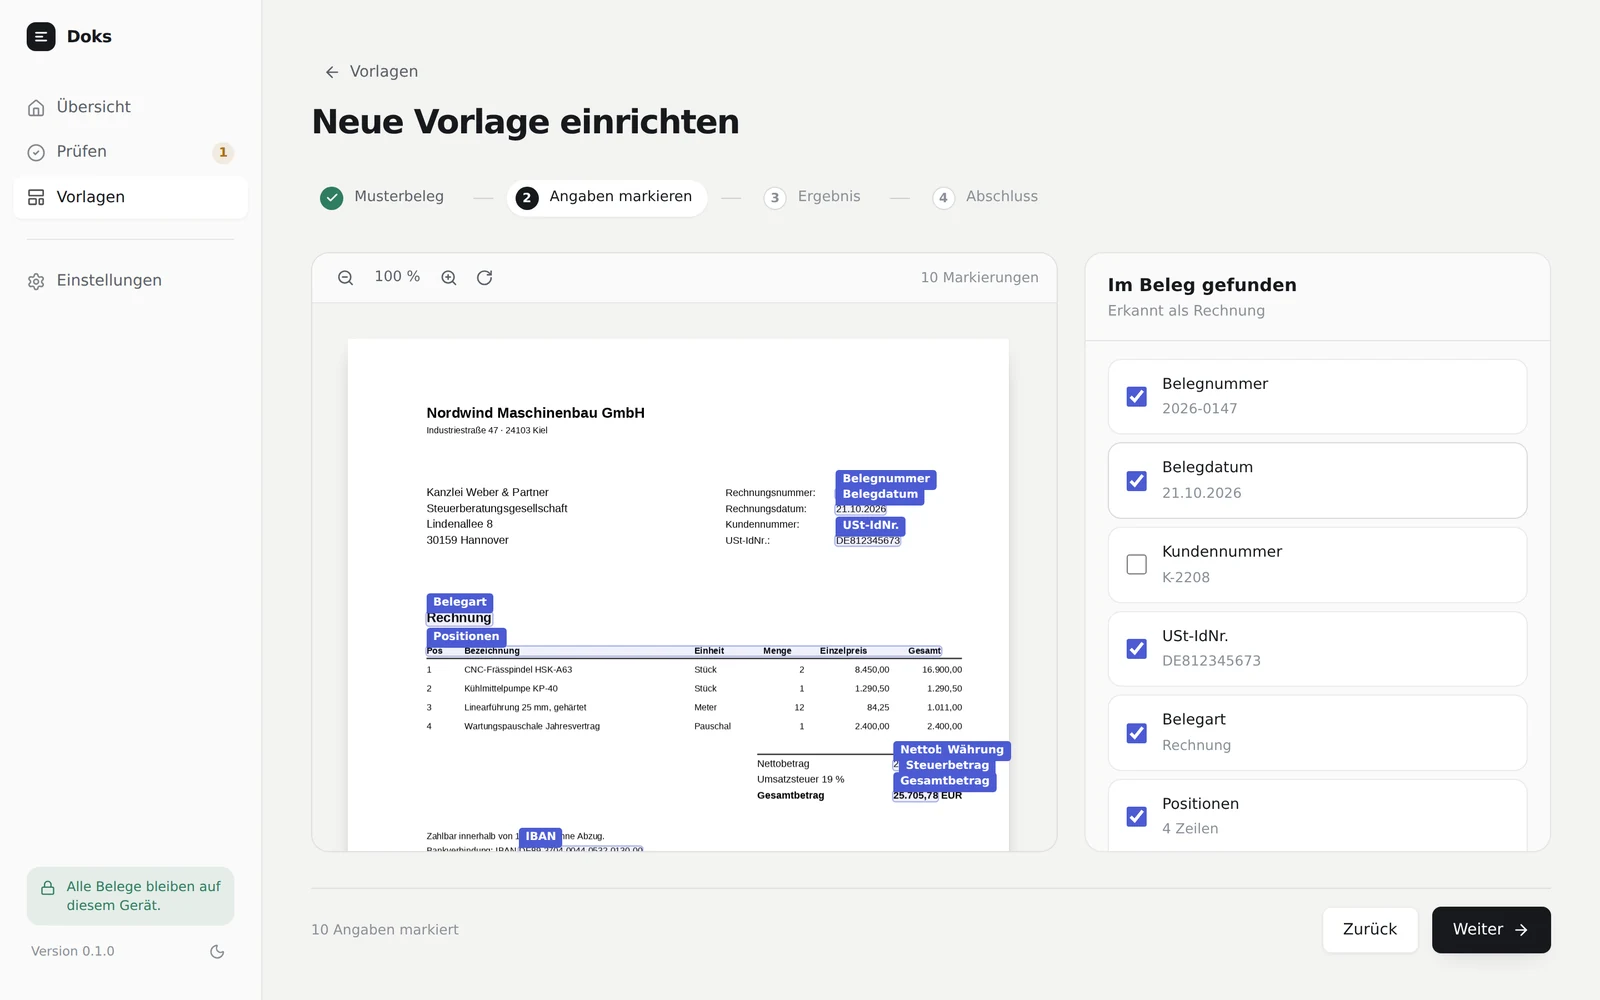
- Eine neue Vorlage: Doks liest den Musterbeleg vorab aus und schlägt jede gefundene Angabe zum Ankreuzen vor, die Positionen als Liste. (Helles Theme)
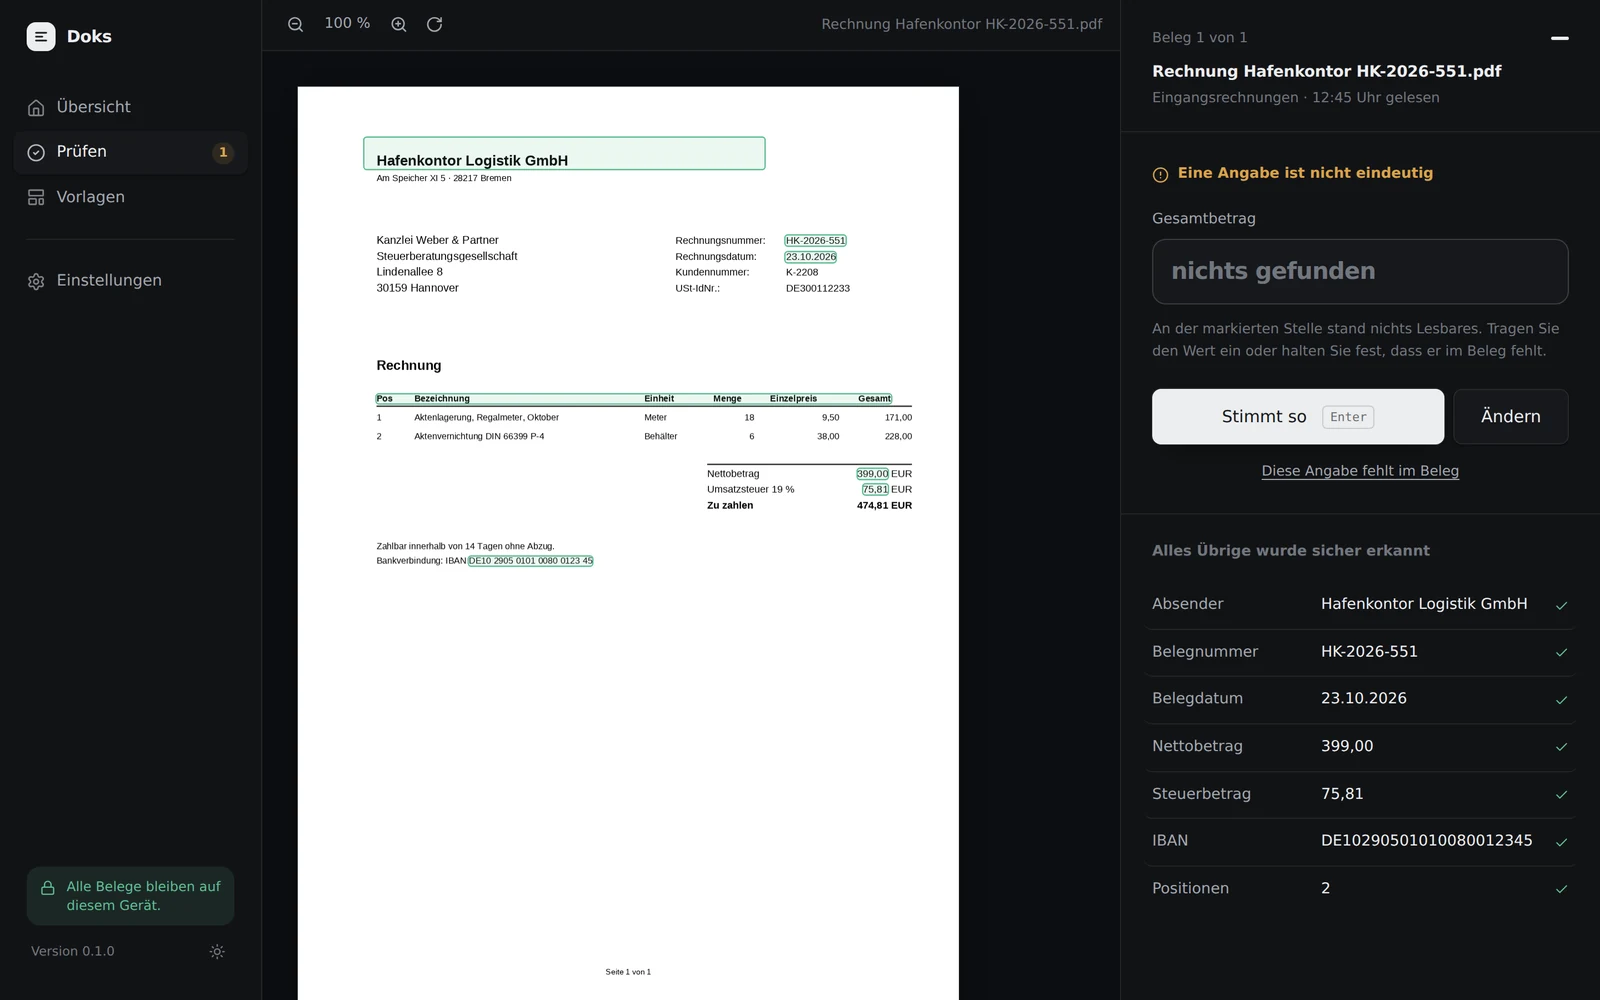
- Dieselbe Prüfung im dunklen Erscheinungsbild. (Dunkles Theme)
Stand
Stufe 2 ist abgeschlossen: Laden, Anzeigen und Indizieren von PDF, Excel und Bildern funktionieren, ebenso das Auslesen der Werte, jeweils mit der Stelle im Beleg, an der ein Wert gefunden wurde. In Stufe 3 sind ein lokales Sprachmodell über llama.cpp und überwachte Eingangsordner gebaut. Beim Einrichten einer Vorlage liest Doks den Musterbeleg vorab aus und schlägt alle gefundenen Angaben zum Ankreuzen vor; Rechnungspositionen kommen als Liste mit Summenprobe und landen Zeile für Zeile in der Tabelle. Offen ist noch, dass Doks die passende Vorlage selbst erkennt. Export, Stapelverarbeitung und Installer folgen in Stufe 4. Die Oberfläche ist standardmäßig deutsch, Englisch lässt sich in den Einstellungen wählen.
Open Source
Der Quellcode liegt öffentlich auf GitHub unter MarcusBaitz/doc-extractor und steht unter der Apache-Lizenz 2.0. Jeder darf Doks verwenden, verändern und weitergeben, auch kommerziell.
Technik: Tauri, Rust, Python, Local AI, SQLite
Fragen zu diesem Projekt oder zu einem ähnlichen Vorhaben?
Anfrage senden